编者按:随着 Agent 从对话走向真实任务执行,模型之外的 Harness、工具调用与环境反馈正在成为新的能力来源。基元律动此次发布 NeoHorse-1,首次将其 Routing Harness 中沉淀的 Agent 执行轨迹系统性用于模型训练,并完成了一次从数据生成、能力反馈到模型更新的单轮闭环验证。这次发布的意义或许不只在于一个新的 4B/9B 模型,而在于对“如何把 AI 的真实执行经验转化为下一轮模型能力”这一技术路径的工程化探索,基于 Agent 执行轨迹开展模型后训练,探索从真实任务反馈中提升模型能力。华兴持续关注 AI 基础设施与模型演进的新技术路径。
近日,基元律动(TokenRhythm)联合无问芯穹,与清华大学、北京大学、香港中文大学、阿里巴巴等伙伴一起,正式发布首个自研模型 NeoHorse-1,提供 4B 与 9B 两个版本。
NeoHorse-1 是一款面向 Agent 场景训练的语言模型,支持工具调用、任务规划、深度搜索与代码生成等任务,初步具备 Agent 原生(Agent-Native)能力,在多项 Agent 子任务上达到同规模模型SOTA。与通用基座模型不同,NeoHorse-1 的训练数据大量来自被Harness调用而产生的结构化轨迹,模型自训练之初即面向“完成任务”而非“回答问题”。
此次发布的意义不止于一个模型。我们同步验证了 RSI(Recursive Self-Improvement,递归自改进)的 Data-RSI 与 Model-RSI 两个环节首次在同一个 Harness 框架内形成闭环,这也是在“执行经验转化为模型能力”技术路径上的首次交付。
技术报告链接:
https://github.com/TokenRhythm/NeoHorse/blob/main/TechnicalReport_NeoHorse_v1.pdf

内部评测:在多项 Agent 子任务上达到同规模模型SOTA
内部评测结果显示,NeoHorse-1 4B 在 Agent 任务上的表现已超过多个参数量显著更大的通用模型;9B 版本在更复杂的推理与长程规划任务上表现更优。两个规模的后训练增益,都最突出地体现在 Agentic 任务上。
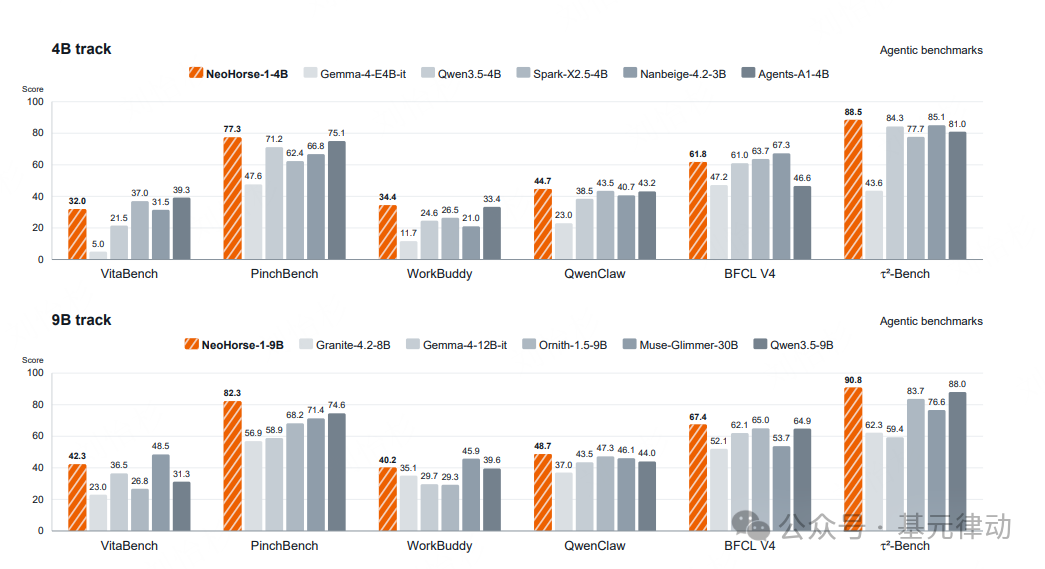
NeoHorse-1-4B 在 τ²-Bench、PinchBench、WorkBuddy、QwenClaw 等多项 Agent 子任务上均排名同规模对比模型第一,综合宏平均分 64.87 位列 4B 同规模模型之首;NeoHorse-1-9B 同样在 BFCL v4、τ²-Bench、PinchBench、QwenClaw 等工具调用与交互式 Agent 子任务上排名第一,宏平均分从底座的 65.60 提升到 69.04。
这并非巧合。Agentic Post-Training 补强的正是“获取证据 → 更新约束 → 执行 → 验证 → 交付”这条执行闭环:这类任务流程清晰、环境反馈可观察、成败可验证,后训练的红利最直接。因此两个模型的能力提升都集中落在 Agentic 与工具交互任务上,而非相对静态的指令遵循或普通对话场景。
我们认为,NeoHorse-1 仍处于早期阶段,4B 与 9B 两个版本距离既定目标尚有差距。本次发布的价值不在参数规模,而在于验证了一条路径的可行性:从 Agent 任务中产生的数据,能够训练出服务于 Agent 任务的模型;更强的 Agent 模型,能够交付更好的任务结果。
从 Agent 任务中来:Harness 轨迹构成训练数据底座
训练语料以 Routing Harness 在 Agent 执行场景中产生的结构化轨迹为核心,并辅以公开数据。
一次完整的任务执行,会在 Harness 中留下结构化记录:任务请求、能力需求评估、路由选择、模型响应、工具调用、环境反馈、错误与恢复路径、最终完成状态。相比传统问答语料“题目与答案”的形态,执行轨迹多出三个维度的信息:能力需求、执行决策、环境结果。其中既有成功经验,也有被中途替换的失败轨迹——最终答案只能说明“怎么做对”,失败与修复过程则说明“哪里容易出错、出错后如何恢复”。
Agent 轨迹通常很长,包含系统提示、工具参数、重复尝试、错误信息与中间输出,不能直接用于训练。据技术报告,每条轨迹先经过结构检查,确认请求、模型回复、工具调用与环境结果之间正确对应;再从六个维度进行质量评估:是否完成任务目标、是否遵循指令、工具使用是否合理、结论是否有证据支撑、遇到错误后是否恢复、是否在正确时机终止。
由此,NeoHorse-1 从第一天起即为完成任务而训练,而非在通用模型基础上事后适配 Agent 场景。这也是我们讲的 Agent-Native。
另一方面,本次 Beta 版本同步上线 Playground——登录后从导航栏“体验”进入,无需写代码,直接在浏览器中选模型、配参数、和模型对话。可以用来:
Agentic Post-Training:路由信号不只用来选模型,也用来训模型
数据筛选完成后,路由信号在训练中发挥第二个作用。
Harness 路由器在每一轮对话上估计“这个任务需要多强的能力”,并归入四个服务档位:C0 处理边界清晰的低风险请求,C1 是通用默认档,C2 支持多步推理与执行,C3 提供最高能力或最高可靠性。这个档位判断原本只用于线上选模型,NeoHorse-1 把它变成了训练信号。
训练完成后,将路由记录拆成“预测—行动—结果”三段:路由器预测的能力需求、策略实际选择的档位、以及任务最终结果。这种分离让训练侧只用“预测”来排课程,而“结果”字段则提供能力短板信号——哪些子场景反复失败、哪些环节恢复成本高、哪些能力档位供给不足。
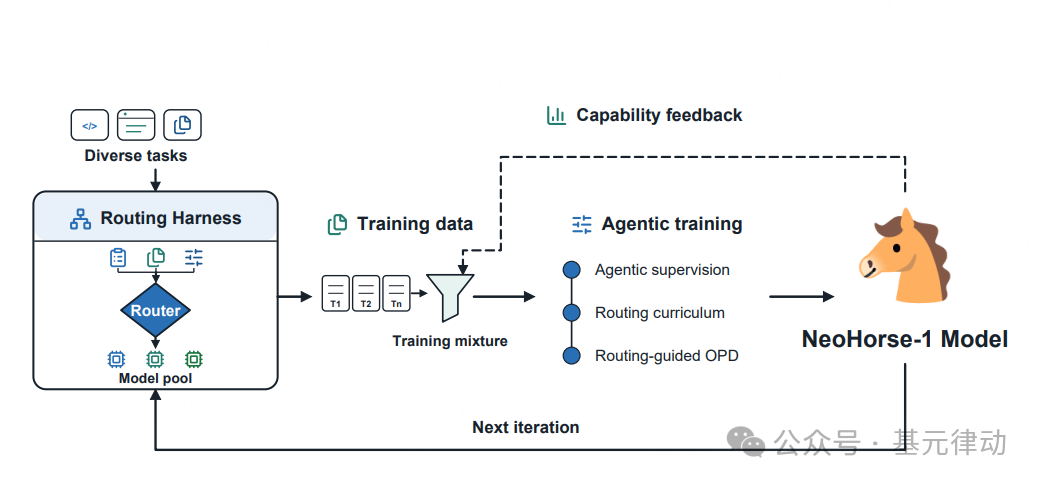
这些短板信号被用来调整下一轮的训练数据配比,形成“评测反馈 → 数据配比 → 更新模型”的闭环。报告称之为 Capability-Guided Data Allocation(能力引导的数据配比)。
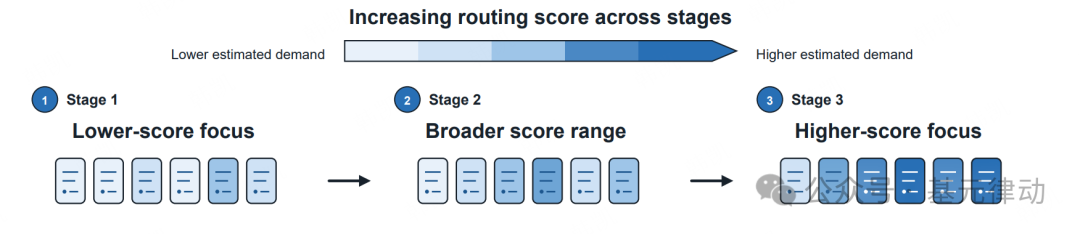
概括来说:路由负责“这个任务该给谁做”,NeoHorse-1 让它同时负责“这个模型该先学什么、后学什么”。 同一套能力判断,既是在线服务的决策机制,也是离线训练的数据组织方式——这是 Harness 与模型训练首次共用一套信号。
RSI:Data-RSI 与 Model-RSI 首次在同一 Harness 内闭环
-
NeoHorse-1 同时是递归自我改进(RSI,Recursive Self-Improvement)的一次单轮工程验证。闭环分为两部分:Data-RSI:模型在 Harness 中持续执行任务,每一次路由、工具调用、失败恢复与最终结果都产生新的结构化记录,经筛选处理后成为后续训练的候选材料,随系统运行自然增加;
-
Model-RSI:系统根据评测结果定位当前模型的能力短板,调整下一轮训练数据分布,更新模型,再把新模型放回 Harness 模型池继续工作。
用一句话概括:模型既从执行经验中学习,也通过新的执行过程,为下一轮学习提供反馈。
不过,当前的NeoHorse还不能被称为完整RSI。
技术报告验证的是一次“执行—评估—选择—更新”闭环。信号编译、奖励设计和训练流程仍然由人类设定,多代模型能否持续获得稳定增益,也有待后续实验。
所以更准确的说法是,NeoHorse的这次发布,同时给出了两层验证:为商业飞轮中的“执行经验转化为模型能力”提供实验依据,也完成了一次面向RSI的单轮工程验证。
我们的商业闭环为:OpenSquilla 承接Agent任务 → Routing 识别各环节最优模型 → TokenRhythm API 将能力规模化输出 → 产生更多任务反馈 → 迭代 Routing → 迭代模型 → 模型进入模型池使用。
在此之前,该闭环中的“模型”一环始终依赖外部供给。NeoHorse-1 的发布补齐了这一环,使飞轮具备自转条件:Harness 产生的轨迹,确实能训练出更好的 Agent 模型;更好的 Agent 模型,确实能交付更好的结果。
多方协同:基础设施与算法创新
NeoHorse-1 由基元律动联合多家机构共同完成:
-
作为联合首发方,无问芯穹在底层基础设施与Infra优化方面提供了关键支持——基于推理优化技术支持了大量推理任务(Agent 任务跑起来很吃底层资源,没有无问,我们跑不出这个规模),并通过弹性训练系统等核心技术提升模型训练效率及稳定性。
-
由汪玉老师发起,清华大学、北京大学、香港中文大学团队参与算法与训练方法创新,探索提升训练投入的能力回报,推动形成更陡峭的训练 Scaling 曲线;阿里巴巴等多家机构在模型推理等方面提供支持。
个人榜与应用榜也在开发的路上,让每一位 AI 创造者的坚持都被看见。
开放调用
NeoHorse-1 已开源,可通过以下地址获取。
Huggingface平台:
https://huggingface.co/collections/TokenRhythm/neohorse-1
ModelScope平台:
https://www.modelscope.cn/collections/TokenRhythm/NeoHorse-1
Github平台:
https://github.com/TokenRhythm/NeoHorse
我们的核心判断保持不变:模型数量将持续增加,专业化程度持续加深,成本持续下降,模型之间不会归一,而是需要被组织。NeoHorse-1 将回到多模型协作网络中,占据一个为 Agent 场景而生的位置。
NeoHorse,智能新马力。
官网:tokenrhythm.cn
免责声明:本文由基元律动授权转发,谨供读者作参考用途,不应被视为在任何地区针对任何证券的研究报告,不构成买卖、认购证券或其它金融工具及产品的邀请或保证。读者不应仅依靠本文、而应按照自己的判断作出投资决定,并在作出任何投资行动前咨询专业意见。华兴资本不就本文内容作出任何陈述或保证,亦不承担因对本文的使用、不当使用、依赖、分发或占有而产生的任何责任。第三方链接与交易: 文中包含的第三方网站链接、二维码及服务入口(包括但不限于 API 调用、账号注册、充值缴费等)仅为提供便利。读者与第三方之间发生的任何服务协议、商业交易及数据隐私纠纷均由读者与第三方自行承担,华兴资本对此概不负责。
精彩评论